
Day 23 的資料庫是用 Deployment 跑的,也跑得好好的。
那為什麼大家都說資料庫要用 StatefulSet?
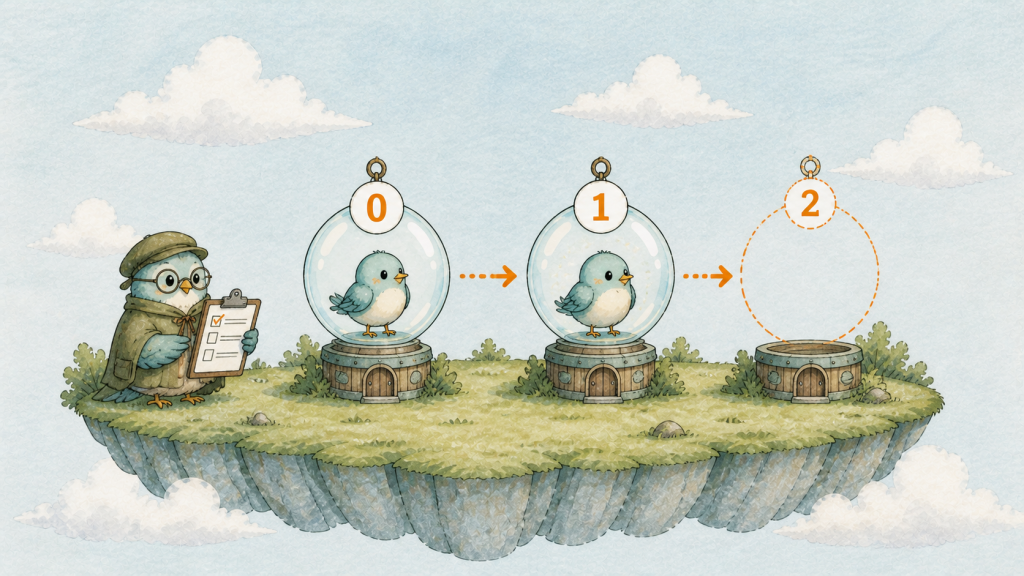
三顆泡泡(Pod)各自掛著 0、1、2 號碼牌,泡泡(Pod)裡各有一隻小鳥(Container),下方各連著一座專屬的倉庫(PersistentVolume,PV)。
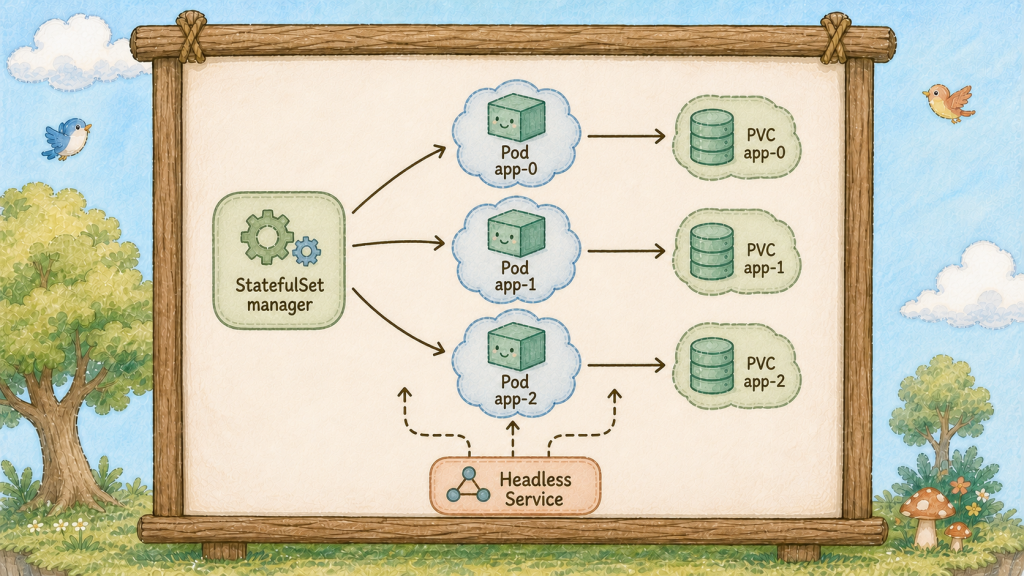
Deployment 手下的泡泡(Pod)適合可替換的工作負載;需要穩定身分、順序或專屬儲存的工作負載,則需要另一種管理方式。
回想貓頭鷹(ReplicaSet)的個性(Day 9):它只數數字,不認得哪顆是哪顆。
所以 Deployment 的泡泡(Pod)有三個特徵:
名字隨機,hello-7d4b8c-xk2p9,重建一次就換一串。
沒有順序,三顆同時吹出來,誰先誰後不一定。
共用倉庫(PV),大家掛同一張借用單(PersistentVolumeClaim,PVC)。
這三件事很適合前端服務;資料庫若需要固定身分與專屬資料,就要改用 StatefulSet 的模型。
看圖上泡泡(Pod)外壁的號碼牌,StatefulSet 把三件事一次改掉。
第一,固定的名字
泡泡(Pod)叫 hello-db-0、hello-db-1、hello-db-2,在泡泡(Pod)外掛著號碼牌。
刪掉 hello-db-1,補回來的仍叫 hello-db-1,名稱會保留編號。
第二,一鳥一倉庫(PV)
每個編號各自綁一張自己的借用單(PVC)、一座自己的倉庫(PV)。hello-db-1 重建之後,接回去的是它原本那座倉庫(PV),資料原封不動。
這是整個 StatefulSet 最核心的價值。
第三,預設的 OrderedReady 策略有順序
啟動通常是 0 → 1 → 2,一顆就緒才建立下一顆;關閉則反向進行。
若設定 podManagementPolicy: Parallel,就不必等待這個順序。
資料庫的主從架構、分散式系統的初始化,全都靠這個順序。
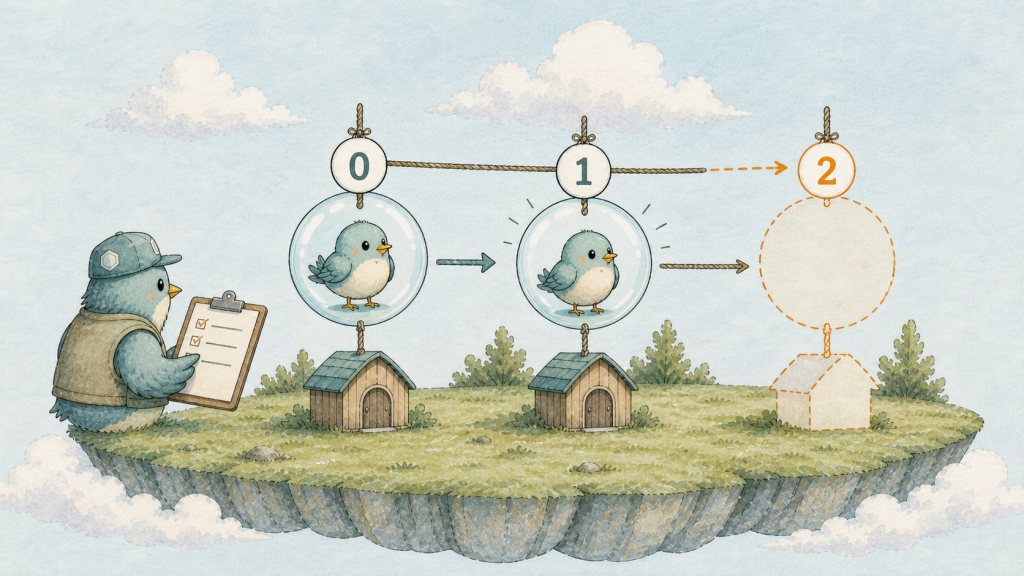
三顆帶著 0、1、2 號碼牌的泡泡(Pod)由左到右依序建立,1 號還沒 Ready 時,2 號的位置還空著。
StatefulSet 還有一個必配的東西:Headless Service(無頭的圖騰柱(Service))。
一般的柱子(Service)有自己的 IP,會幫忙隨機挑一顆泡泡(Day 18 那條地道)。
但連資料庫的主節點時,要的就是那一顆,不要隨機挑。
所以 StatefulSet 配一根特別的柱子(Service):clusterIP: None。
它沒有自己的 IP、不做任何轉發,只提供 DNS,讓我們可以用 hello-db-0.hello-db 這種帶編號的地址叫到指定的那顆泡泡(Pod)。
一句話總結今天:Deployment 管的是「三個一樣的東西」,StatefulSet 管的是「三個不一樣、而且分得出誰是誰的東西」。
那什麼時候該用?判準只有一條:這顆泡泡(Pod)有沒有「只屬於它自己」的資料或身分?
有穩定身份、順序或每顆 Pod 專屬儲存需求時,才考慮 StatefulSet;資料庫、訊息佇列與分散式快取還要看應用程式和 Operator 的需求。
沒有就用 Deployment,那是九成的情況。
前二十六天我們示範的工作負載都是 Deployment。今天讓編號泡泡(StatefulSet Pod)管理員建立一組帶號碼牌的泡泡(Pod),把三個差異一次看完。
建立 demo-statefulset.yaml:
apiVersion: v1
kind: Service
metadata:
  name: demo-sts
spec:
  clusterIP: None
  selector:
    app: demo-sts
  ports:
    - port: 80
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: demo-sts
spec:
  serviceName: demo-sts
  replicas: 3
  selector:
    matchLabels:
      app: demo-sts
  template:
    metadata:
      labels:
        app: demo-sts
    spec:
      containers:
        - name: web
          image: nginx:1.27-alpine
          volumeMounts:
            - name: data
              mountPath: /data
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 100Mi
今天多看的三個欄位是:clusterIP: None(無頭柱子,Headless Service)、serviceName(指定配哪根柱子)、volumeClaimTemplates(借用單(PVC)的模板,每個編號各產生一張)。
--- 是 YAML 的分隔線,一個檔案裡放兩份資源。
kubectl apply -f demo-statefulset.yaml
kubectl get pods -l app=demo-sts -w
盯著看,這是今天最好看的地方。 泡泡(Pod)是一顆一顆出現的:demo-sts-0 先 Running,然後 demo-sts-1 才開始 ContainerCreating,最後才是 demo-sts-2。Deployment 是三顆同時冒出來的,差別一眼可見。Ctrl+C 離開。
差異一,名字:
kubectl get pods -l app=demo-sts
demo-sts-0、demo-sts-1、demo-sts-2。沒有一串亂碼。
差異二,一鳥一倉庫(PV):
kubectl get pvc
data-demo-sts-0、data-demo-sts-1、data-demo-sts-2 ── 三張借用單(PVC),各綁各的倉庫(PV)。你只寫了一份模板。
寫點只屬於 1 號的資料進去:
kubectl exec demo-sts-1 -- sh -c "echo 'I am number one' > /data/id.txt"
kubectl exec demo-sts-1 -- cat /data/id.txt
現在做關鍵實驗,把 1 號砍掉:
kubectl delete pod demo-sts-1
kubectl get pods -l app=demo-sts
補回來的泡泡(Pod)還是叫 demo-sts-1。等它 Running,然後:
kubectl exec demo-sts-1 -- cat /data/id.txt
I am number one 還在。 這次 demo 中它接回了自己原本那座倉庫(PV);前提是 PVC、PV 與掛載流程都正常。Deployment 補出的 Pod 名稱會改變,StatefulSet 則能依序接回對應的 PVC。
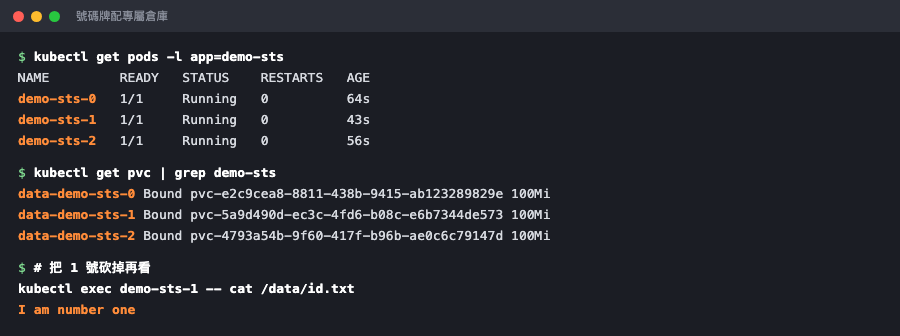
三顆泡泡(Pod)的名字是 0、1、2,三張借用單(PVC)也是 0、1、2 ── 一一對應。
差異三,帶編號的地址:
kubectl run dns-test --rm -it --image=busybox:1.36 -- \
  nslookup demo-sts-1.demo-sts.default.svc.cluster.local
印出那顆泡泡(Pod)的 IP。你叫得到指定的那一顆。
(這裡使用完整位址。busybox 的 nslookup 對叢集搜尋網域的處理可能和應用程式不同;完整名稱最穩定。)
至於你的 hello-db,要換過去其實只有四個地方要改:kind 換成 StatefulSet、加 serviceName、把 volumes 那段改成 volumeClaimTemplates、柱子(Service)加 clusterIP: None。今天先不動它,知道怎麼換就好。
收工,這組會留下借用單(PVC),記得一起清:
kubectl delete -f demo-statefulset.yaml
kubectl get pvc
kubectl delete pvc data-demo-sts-0 data-demo-sts-1 data-demo-sts-2
注意最後這行。 刪掉 StatefulSet 不會連借用單(PVC)一起刪 ── 這是刻意的保護,免得你手滑砍掉資料。所以清場的時候要多這一步,不然倉庫(PV)會一直留在島上。
再補一個很多人會忽略的差別:在預設 RollingUpdate 策略下,StatefulSet 通常照編號倒著更新。 更新時從編號最大的開始換,一顆就緒才動下一顆;OnDelete 或其他設定會改變這個行為。所以更新一組五顆的資料庫會明顯比更新前端慢,這是正常的,不要中途以為卡住就去手動干預。
號碼牌配專屬倉庫(PV),這才是 StatefulSet。


 iThome鐵人賽
 看影片追技術